
Kvalitu výstupu AI agenta určuje model méně, než by se zdálo. Rostislav Babáček ukázal, které vrstvy si tým staví sám a jak z každé frustrace s agentem udělat trvalé zlepšení systému místo další ruční opravy kódu. Článek vychází z jeho vystoupení na AI pivku v září 2026, interním meetupu, kde si vývojáři Ackee sdílejí, jak s AI agenty skutečně pracují.
📋 TL;DR
- Kvalitu výstupu AI agenta tvoří pět vrstev: model, built-in harness, project setup, zadání a schopnosti vývojáře. První dvě dodává nástroj, zbylé tři si tým staví sám.
- Podle zkušeností z komunity dělají model s harnessem nanejvýš zhruba 20 % výsledku. Zbytek je práce týmu, a proto jde o agentic engineering, ne o vibe coding.
- Drobné komponenty mají velký efekt: princip Tell, Don't Ask v rules vyčistil view od byznys logiky, glossary sjednotil naming a ADR vysvětlilo agentovi, proč je podivná podmínka v kódu schválně.
- Komponenty samy nestačí. Workflows (orchestrační skilly) drží správné pořadí kroků, a tím disciplínu agenta – a místo pěti promptů stačí jeden.
- Analytická fáze je nejdůležitější: krok grill-me nutí agenta doptávat se a konfrontovat zadání s codebase, grill-with-docs k tomu přidává glossary, ADR a API specifikace.
- Multi-phase plán dělený na vertical slices řeší context rot a zaručí, že aplikace jde zbuildit po každé fázi. Commit po fázi pak znamená levný revert.
- Implementační smyčka TDD → deslop → adversarial review → verify → commit běží AFK a každý neúspěšný krok vrací feedback orchestrátorovi.
- Hlavní poučení: neopravujte output, opravujte systém. Co najdete na code review, patří do rules.
😤 Co vývojáři slýchali: frustrace jako výchozí bod
Když Ackee rozjíždělo adopci AI ve vývoji, ozývalo se z kanceláří hodně nadávek na Claude. Nepochopil zadání, takže celá implementace byla k ničemu. Nacpal byznys logiku do view. Choval se nedeterministicky: ráno zapomněl spustit testy, odpoledne testy pustil, ale zapomněl na lint.

Rostislav Babáček, který má v Ackee agentní vývoj na starosti, si tyhle hlášky sepsal a ke každé hledal systémové řešení – pravidlo, skill nebo krok ve workflow. Z toho plyne hlavní myšlenka celého přístupu: kvalita outputu a efektivita nejsou samozřejmost, ale dají se cíleně zvyšovat.
🧱 Pět vrstev kvality outputu: model a harness jsou jen začátek
Babáček dělí faktory, které určují kvalitu výstupu AI agenta, do pěti vrstev:
- Model / LLM – reasoning, schopnost kódovat, dodržování instrukcí, práce s dlouhým kontextem.
- Built-in harness / runtime – systémový prompt, agentní smyčka, spouštění nástrojů, vestavěné skilly, správa kontextu a session, systém oprávnění.
- Project setup –
CLAUDE.md, vlastní skilly, MCP servery, hooky, subagenti, projektové nástroje a znalosti, codebase přívětivá pro agenta a hlavně feedback loop. - Zadání / specifikace – záměr, scope, constrainty, akceptační kritéria, příklady, PRD nebo spec, plán.
- Schopnosti vývojáře – context engineering, rozklad úkolů, orchestrace, řízení agenta, rozhodování v human-in-the-loop krocích, pochopení toho, jak se model chová.

První dvě vrstvy dodává nástroj, ať už je to Claude Code, Codex, Cursor nebo Copilot. Upravovat je je složité. Museli byste sáhnout po open-source harnessu nebo si postavit vlastní řešení přes Agent SDK. K tomu je potřeba přesah do LLM a stavby harnessů, a pro vývojáře, kteří chtějí hlavně dělat aplikace, to podle Babáčka nedává smysl.
Zbylé tři vrstvy si ale tým postaví sám a může je opřít o hard skills, které vývojáři používali i dřív. Na vývojářských meetupech podle Babáčka opakovaně zaznívá, že model s harnessem tvoří nanejvýš zhruba 20 % kvality výsledku a většinu dělají ostatní vrstvy. Je to jeho pozorování z komunity, ne změřené číslo, ale směr sedí s tím, co Ackee vidí na vlastních projektech. Proto o tom v Ackee mluví jako o agentic engineeringu, ne o vibe codingu: staví opakovatelný systém, ne jednorázové prompty.
Ackee dodává klientské aplikace, takže si nemůže dovolit „vibecodit“ a projekt rozsekat. Kvalita výstupu má proto přednost před multiplikátorem rychlosti. Rychlost se dostaví sama, jakmile agent přestane generovat kód, který se pak týden opravuje.
Pátá vrstva, schopnosti vývojáře, je důvod, proč Ackee zavedlo proficiency levely, kterými prošli všichni od nuly. Odpovídají na otázky typu „musím čistit context window v session?“ (ano, musíte) nebo „nahradím linter skillem?“ (ne – deterministické nástroje na kontrolu kódu mají zůstat deterministické).
🧩 Project setup: tři drobnosti, které vylepšily output
Project setup se v Ackee skládá z několika komponent: CLAUDE.md jako vstupní kontext projektu, .claude/rules s tvrdými pravidly pro kód, projektový kontext (glossary, ADR, API specifikace, DB schéma, Figma), skilly, hooky a MCP servery, ustálená workflows a GitLab review rules jako jediný zdroj pravdy pro CI.
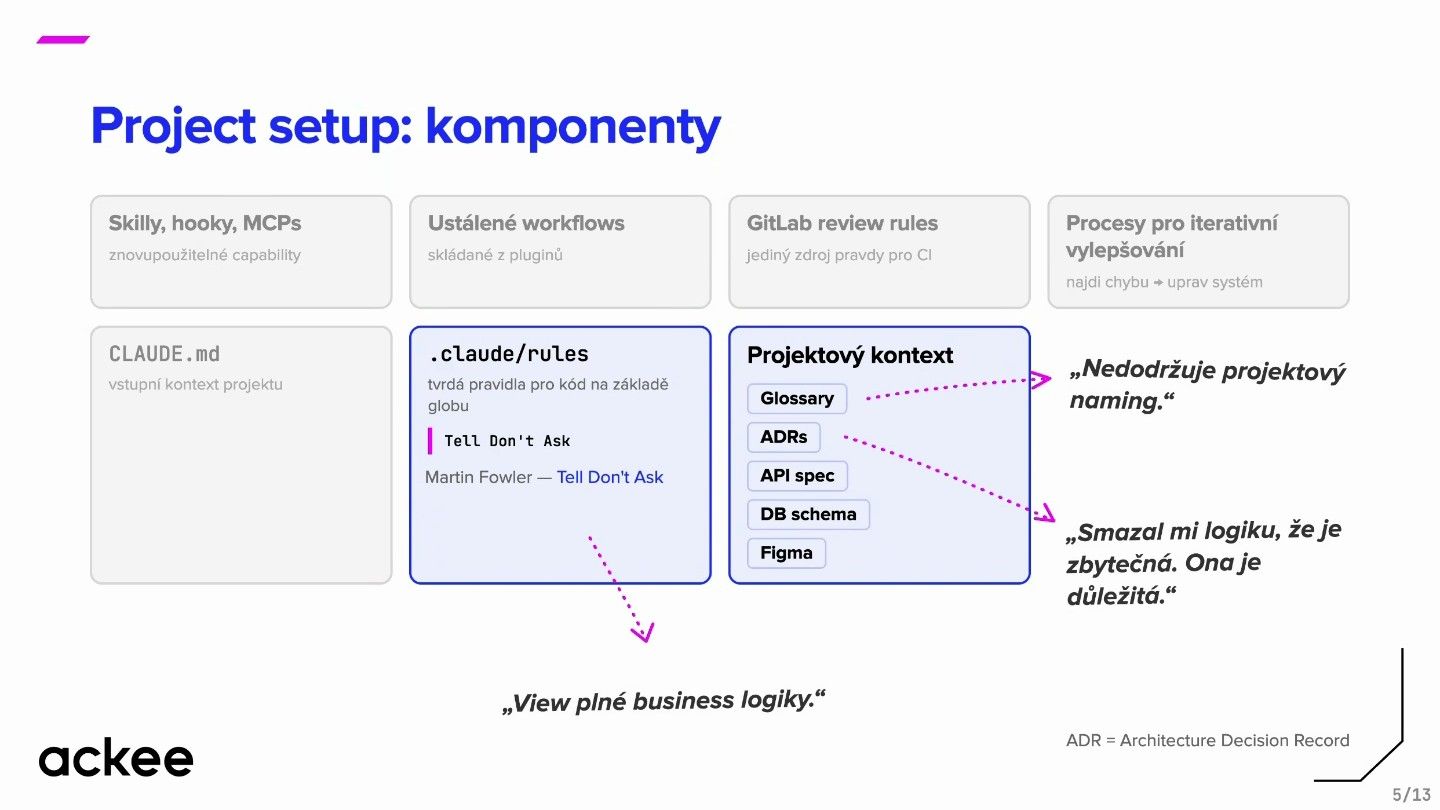
Babáček ukázal tři konkrétní případy, kdy malá úprava setupu výrazně zlepšila výsledek:
- Tell, Don't Ask proti byznys logice ve view. Na jednom projektu končila spousta byznys logiky ve view. Kolega přidal do rules princip Tell, Don't Ask (spojovaný s Andym Huntem a Davem Thomasem, autory The Pragmatic Programmer, a popsaný mimo jiné Martinem Fowlerem) a k němu příklad. Problém zmizel.
- Glossary proti vymyšlenému namingu. Claude pojmenovával funkce a třídy, jak ho zrovna napadlo. Projektový slovník pojmů mu teď pro každý pojem říká, který z několika synonym je ten hlavní, a agent se ho drží.
- ADR proti mazání „zbytečné“ logiky. Na streamovací aplikaci si BI vymyslelo specifickou metriku. Claude opakovaně tvrdil, že podmínka, která ji počítá, je zbytečná a měla by zmizet. Pomohlo přidat architektonické rozhodnutí (ADR, architecture decision record), které si agent načte při práci s daným modulem. Teď ví, že podmínka je tam schválně.
Jsou to maličkosti, ale přesně o nich agentic engineering je: ke každé frustraci najít komponentu, která ji systémově vyřeší.
🔁 Workflows: jak donutit agenta k disciplíně
Komponenty samy o sobě nestačí, musí zapadnout do procesu. Babáček často slýchal otázky typu „v jakém pořadí mám ty skilly pouštět?“ nebo „kdy mám volat build a kdy commit?“. Ruční pouštění skillů navíc zdržovalo: commit skill trvá třeba minutu, a když ho vývojář volá ručně mezi kusy implementace, je to neefektivní.
Řešením jsou workflows: plugin s orchestračním skillem, který spouští ostatní skilly ve správném pořadí. Přináší dvě věci:
- Disciplínu. Agent nevynechá krok ani ho neprohodí s jiným, protože pořadí určuje workflow.
- Efektivitu. Místo pěti promptů stačí jeden. Agent běží 20–30 minut AFK a vývojář ho nemusí každých pět minut popostrčit.
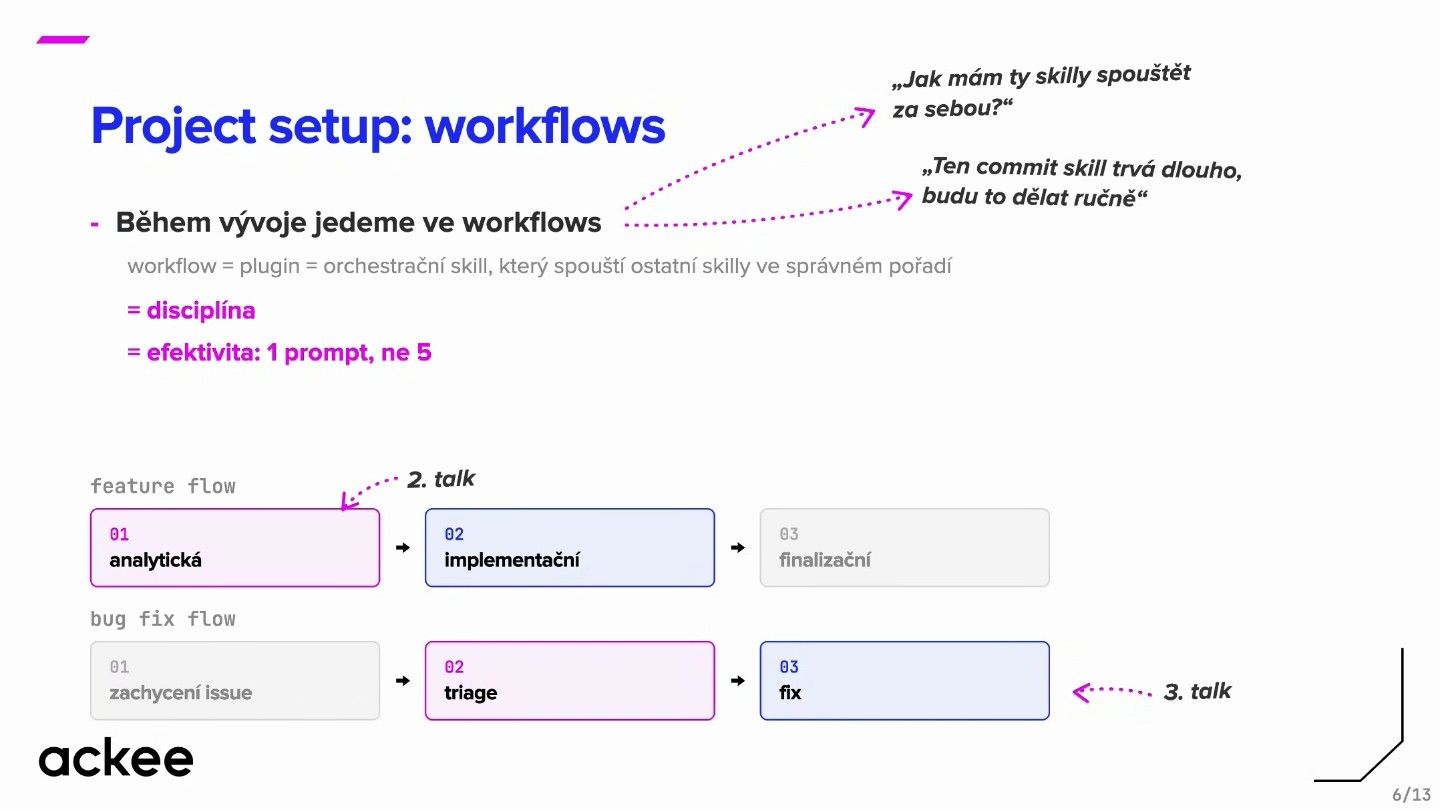
Ackee dnes pracuje se dvěma hlavními flow: feature flow (analytická, implementační a finalizační fáze) a bug fix flow (zachycení issue, triáž, oprava). Jak může analytická fáze vypadat na konkrétním projektu, ukazuje článek o PRD flow. Bug fix flow rozebírá článek o autonomní opravě bugů.
Stává se, že na projektu A vznikne build & test skill a na projektu B ho někdo napíše znovu. Než založíte nový plugin v projektovém marketplace, zvažte, jestli nepatří do sdíleného marketplace. Jinak tým dělá duplicitní práci a posouvá se pomaleji.

🔍 Analytická fáze: grill-me, který nutí agenta se doptávat
Za nejdůležitější fázi celého procesu Babáček považuje analytickou. Zadání pro agenta by podle něj mělo mít takovou kvalitu, jakou byste potřebovali vy sami, kdybyste přišli na cizí projekt bez kontextu a měli dodat task bez chyb. Agent ten kontext sám mít nebude, musíte mu ho dodat i s akceptačními kritérii.
Analytickou fázi spouští příkaz /start-feature s odkazem na tiket a tvoří ji čtyři kroky: fetch-ticket (běží AFK), interview-me, tedy grilování (human in the loop), to-tech-spec (AFK) a to-plan. Výstupem jsou soubory spec.md a plan.md.
Ackee nejdřív používalo plan mode: Claude udělal exploration a vytvořil plán. Často se ale ukázalo, že zadání nepochopil. Načetl tiket, jenže neviděl všechny souvislosti a neměl možnost se doptat nebo zadání konfrontovat s codebase. Proto do procesu přibyl krok inspirovaný skillem grill-me Matta Pococka. Agent se doptává a průběžně porovnává zadání s kódem, takže se v zadání postupně odhalují díry a výsledné řešení má mnohem vyšší kvalitu. Tenhle krok běží vždy s člověkem a Ackee ho automatizovat nechce.
Když pak klient v zadání použil pro jednu věc dva různé pojmy, Claude se znovu zmátl. Grilování se proto rozšířilo na grill-with-docs, který během doptávání načítá projektový kontext: glossary, architektonická rozhodnutí, API specifikace a další dokumentaci.
🍰 Multi-phase plán a vertical slices proti context rotu
S dobrým zadáním se objevil další problém. Agent začal kódit, a najednou odbočil od plánu: hrabal se v souborech, které v plánu vůbec nebyly, nebo dělal úplně jiné úkoly. Příčinou byl přeplněný kontext a context rot – s rostoucím kontextem model přestává spolehlivě dodržovat instrukce.
Odpovědí je vlastní skill to-plan, který vytváří multi-phase plán. Implementaci rozseká na menší fáze, takže se agent nedostane do přeplněného kontextu, kde přestává dodržovat disciplínu.
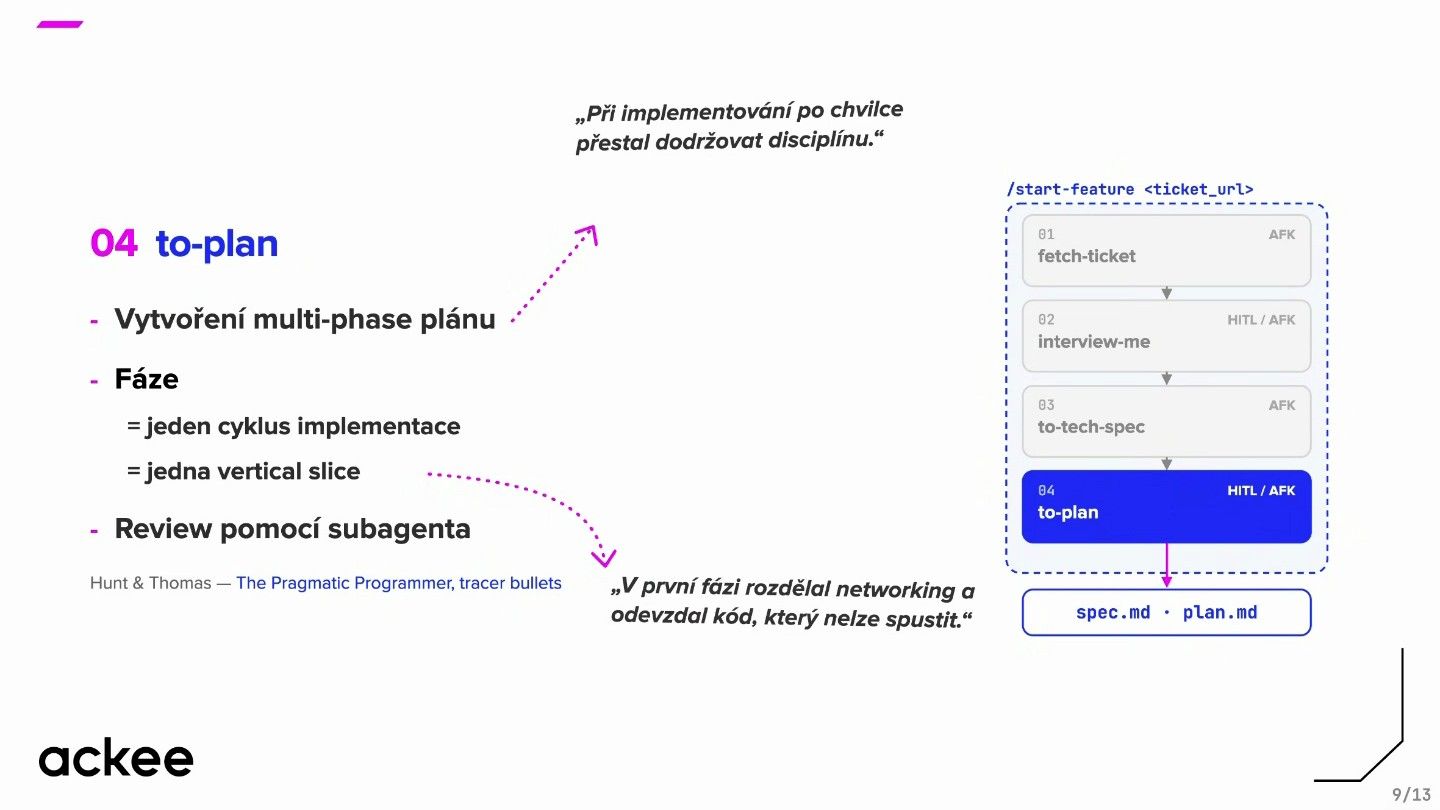
Pak přišla další lekce. Babáček měl na streamovací aplikaci hotové tři fáze z pěti a chtěl si ručně vyzkoušet stahování obsahu, které mu agent neotestuje. Aplikace ale nešla zbildit, protože první fáze rozdělala networking a kód nešel spustit. Plán proto teď pracuje s vertical slices (příbuzný koncept tracer bullets popisují Hunt a Thomas v The Pragmatic Programmer): jedna fáze odpovídá jednomu implementačnímu cyklu a jedné svislé vrstvě funkcionality, takže aplikace jde zbildit a otestovat po každé fázi.
U migrace v rámci jedné vrstvy architektury nejsou vertical slices ideální. U mobilních aplikací jsou ale skvělé: nestane se, že by aplikace v nějaké fázi nešla spustit.
Nově se plán i spec automaticky reviewují: po vytvoření plánu se spustí subagent, udělá review a případný feedback se do plánu rovnou zapracuje.
⚙️ Implementace: TDD, deslop a adversarial review ve feedback loopu
Ani multi-phase plán nezabránil tomu, aby agent občas zapomněl spustit lint nebo snapshot testy. V CLAUDE.md bylo napsané, že má pustit build & test skill, ale proces na to chyběl. Proto vznikl implementační orchestrátor pro Claude Code (původně /do-work, pak /do-work-with-subagents, pracovně /ack-implement). Pracuje s multi-phase plánem a deleguje práci na subagenty. Pro každou fázi plánu proběhne jeden cyklus:
- TDD. Test-driven development je metoda, kterou zpopularizoval Kent Beck. Dřív na ni vývojáři často neměli trpělivost, s agentem se ale vyplácí, protože ho dobře řídí.
- Deslop – úklid zbytečností po agentovi.
- Adversarial review – nezaujatá kontrola subagenty.
- Verify – build, testy, lint, snapshoty. Aplikace musí jít vždy zbildit.
- Commit – po každé fázi.
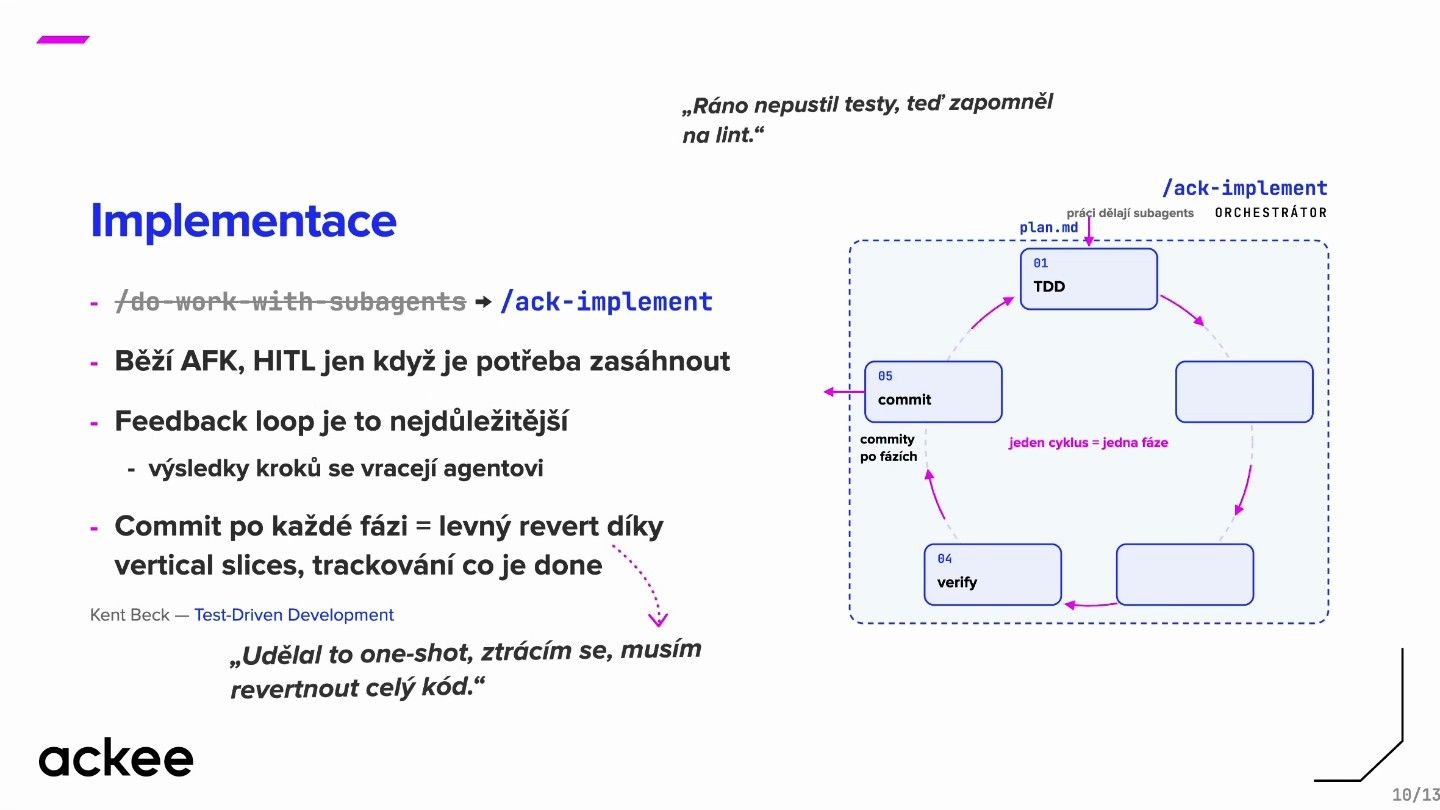
Nejdůležitější jsou feedback loopy. Když některý krok neprojde, výsledek se vrátí orchestrátorovi nebo implementátorovi, ten problém opraví a cyklus proběhne znovu. Kroky tak zaručují, že se vždy použijí všechny validace, které si tým definoval. Celá fáze může běžet AFK a vývojář zasahuje jen tehdy, když je to potřeba.
Commit po každé fázi
Jednou Claude hodinu pracoval na velkém plánu a pak vyplivl obrovskou změnu najednou, bez jediného commitu. Když se Babáčkovi něco nezdálo, mohl jen revertovat úplně všechno. Teď workflow commituje po každé fázi. Díky vertical slices jde aplikace zbildit po každém commitu, takže commity fungují jako levné reverty. Vývojář vidí, jak kód postupně přibývá, a může včas zasáhnout. Commit messages navíc zaznamenávají, která fáze je hotová, a agent z nich ví, kde pokračovat.
Deslop: méně komentářů, méně abstrakcí
Implementace byla správná, ale agent v ní nechával spoustu zbytečných komentářů. Novější modely jsou v tomhle už střídmější, ale problém nezmizel. Jindy napsal na 50 řádků to, co šlo napsat na 10, vytvořil zbytečné abstrakce nebo zduplikoval kód, který šel vytáhnout do jedné funkce.
Proto vznikl skill deslop (podobně pojmenovaný skill má například Cursor). Projde diff a odstraní zbytečné komentáře. Ve feature branchi se k němu přidává simplify na zbytečné zanořování, abstrakce a duplicity. Výhoda je, že skill jde průběžně upravovat podle toho, jak se mění modely a jejich zlozvyky.
Adversarial review: dva subagenti bez biasu
Poslední problém: agent v některých případech nedodržoval .claude/rules. Pravidla se načtou na začátku implementace, ale během ní je agent z různých důvodů nemusí brát jako prioritu. Pomohl review krok, ve kterém subagenti nedostanou kontext implementátora, ale jen git diff. Nemají tedy jeho bias.

Jeden subagent kontroluje dodržení rules, druhý ověřuje, že implementátor udělal v dané fázi všechno, co plán předepisoval. Od zavedení tohoto kroku se Babáčkovi do merge requestu nedostalo žádné porušení pravidel z codebase.
Nabízí se námitka: nešlo by upovídanost řešit už ve fázi plánu nebo ji vynutit přes rules? U deslopu a simplify totiž platíte tokeny dvakrát: jednou za přidání kódu, podruhé za jeho odebrání. Babáček to zkoušel v rules, v CLAUDE.md i v zadání a agent to spolehlivě nedodržoval. Post-processing je zatím jediná varianta, na kterou je spoleh. U běžně velkých implementací navíc cena tokenů podle něj nehraje velkou roli. S dalšími modely se to může zlepšit, takže stojí za to zkoušet to dál.
🔧 Neopravujte output, opravujte systém
Co je tedy k lepšímu outputu potřeba:
- nespoléhat se jen na model a built-in agent harness,
- být součástí budování harnessu a workflows,
- dávat feedback na připravený harness (v Ackee na to slouží feedback skill),
- sdílet svoje zkušenosti,
- vzdělávat se – bez znalosti toho, jak funguje kontext, pluginy nebo progressive disclosure ve skillech, se systém nikam neposune.

Nejdůležitější je ale to, co udělat s vlastní frustrací z agenta.
„Vaše naštvanost je ta nejcennější znalost. Agent neví, že něco dělá špatně a že by to měl zlepšit. Tak tu naštvanost pojďme vždycky přetavit ve vylepšení workflow, ne v nadávání v kanclu.“
Z toho plyne praktické pravidlo: když code review najde chybu, nestačí ji opravit. Musí se propsat do rules, jinak ji agent udělá znovu a tým bude donekonečna opravovat output místo systému. Dobré nápady se navíc mají sdílet. Jeden kolega měl například ve vlastní verzi implementačního skillu na konci krok, který sepíše report, a ten se teď dostane do sdíleného workflow.
Vyplatí se také sjednotit pojmenování workflows napříč projekty. Když se implementační flow všude jmenuje stejně (například /ack-implement), vývojář na novém projektu hned ví, co který příkaz dělá.
Často kladené otázky
🎯 Co si odnést
Model a harness, které dostanete s nástrojem, jsou jen základ. Kvalita outputu AI agenta závisí hlavně na tom, co si tým postaví nad nimi: setup s pravidly a kontextem, kvalitní zadání, workflows s feedback loopy a vývojáři, kteří vědí, jak agenta řídit.
Většina vylepšení přitom nejsou velké projekty, ale drobnosti: jeden princip v rules, slovník pojmů, ADR, commit po fázi, review subagent bez biasu. Každá z nich vznikla z konkrétní frustrace a každá z nich přinesla trvalé zlepšení místo jednorázové opravy.
A nakonec: AI je multiplikátor znalostí, ne jejich náhrada. Víc o tom, jak Ackee přistupuje k agentnímu vývoji jako celku, najdete v článku o Agentic Development Lifecycle.
Minisérie z AI pivka: PRD flow: jedno zadání pro iOS i Android · Autonomní oprava bugů: od tiketu k merge requestu

Podobné postřehy z Ackee najdete v newsletteru – přihlaste se a příští takový obsah vám přijde přímo do schránky.


