
Když AI agent dostane špatné zadání, napíše špatný kód pro obě platformy najednou. Natália Poháňková a Petr Polívka ukázali, jak na bankovní mobilní aplikaci připravují PRD: jeden dokument, ze kterého vychází plán i implementace pro iOS i Android. Článek vychází z jejich vystoupení na AI pivku v září 2026, interním meetupu, kde si vývojáři Ackee sdílejí, jak s AI agenty skutečně pracují.
📋 TL;DR
- PRD (product requirements document) je krátký dokument o tom, co se staví, proč a jak poznáme, že je hotovo. V Ackee je pevnou součástí agentního workflow.
- Na bankovní mobilní aplikaci je zdrojů obrovské množství: zadání z banky, Figma, Confluence, tikety, část za VPN. Kdo projde zdroje a vytvoří PRD, ušetří ostatním učení se feature od nuly.
- PRD je jeden kontrakt pro iOS i Android, vstup pro plánování a trvalá dokumentace toho, proč a jak se něco implementovalo.
- Vstupní bod start-work načte tiket a rozhodne mezi třemi cestami: A (PRD neexistuje, grilujeme), B (PRD už existuje, rovnou plán) a C (malá změna nebo bug, PRD by byla ztráta času).
- Práci dělají subagenti a vracejí artefakty. Orchestrátor drží jen rozhodnutí a shrnutí, takže kontext zůstává čistý.
- Šablona PRD má pevnou hlavičku a sekce od problému po out of scope. Právě out of scope se ukázal jako překvapivě užitečný.
- Flow má zatím sedm human gates. Je to záměr, dokud se proces ladí. Postupně se jich tým chce zbavovat.
- Glossary a ADR vznikají během grilování, ne dodatečně, a žijí ve sdíleném repu jako zdroj pravdy pro obě platformy.
📄 Proč vůbec dělat PRD
Analytická fáze je podle Ackee nejdůležitější částí agentního vývoje (podrobněji o tom v článku o kvalitě outputu AI agenta). Jejím výstupem je PRD: dokument s kompletním kontextem tasku pro lidi i pro Claude Code, zdroji, ze kterých se vycházelo, a otevřenými otázkami na backend nebo produkt.

Petr Polívka a Natália Poháňková pracují na mobilní aplikaci banky pro iOS i Android. Viděli v PRD čtyři hlavní přínosy:
- Sladění před kódem. Společné „co a proč“ vzniká dřív, než se staví. Opravy padnou při grilování, ne až v merge requestu.
- Jeden zdroj pro obě platformy. iOS i Android staví proti stejnému kontraktu a nerozcházejí se.
- Vstup pro AI plánování. Malý strukturovaný dokument se snadno rozpadne na fáze plánu.
- Trvalé „proč“ a definice hotovo. Success criteria říkají, kdy je hotovo. Spolu s ADR a glossary PRD přežije session i odchod lidí.
PRD se navíc dá připravit dopředu, bez implementace. Analýzu může udělat někdo jiný než implementátor, klidně o měsíce dřív. Otevřené otázky se mezitím vyřeší s backendem nebo s klientem na workshopu a implementace pak může začít třeba až po nasazení backendu.
Na bankovním projektu má tým byznys zadání od klienta, design ve Figmě, backendovou dokumentaci v Confluence a spoustu tiketů. Část je navíc za VPN. Když je projde jeden člověk a výsledek zachytí v PRD, druhý se feature nemusí učit od nuly. Stáhne si PRD a jde rovnou do implementace.
🧭 Dvě osy: workflow a dohledatelný kontext
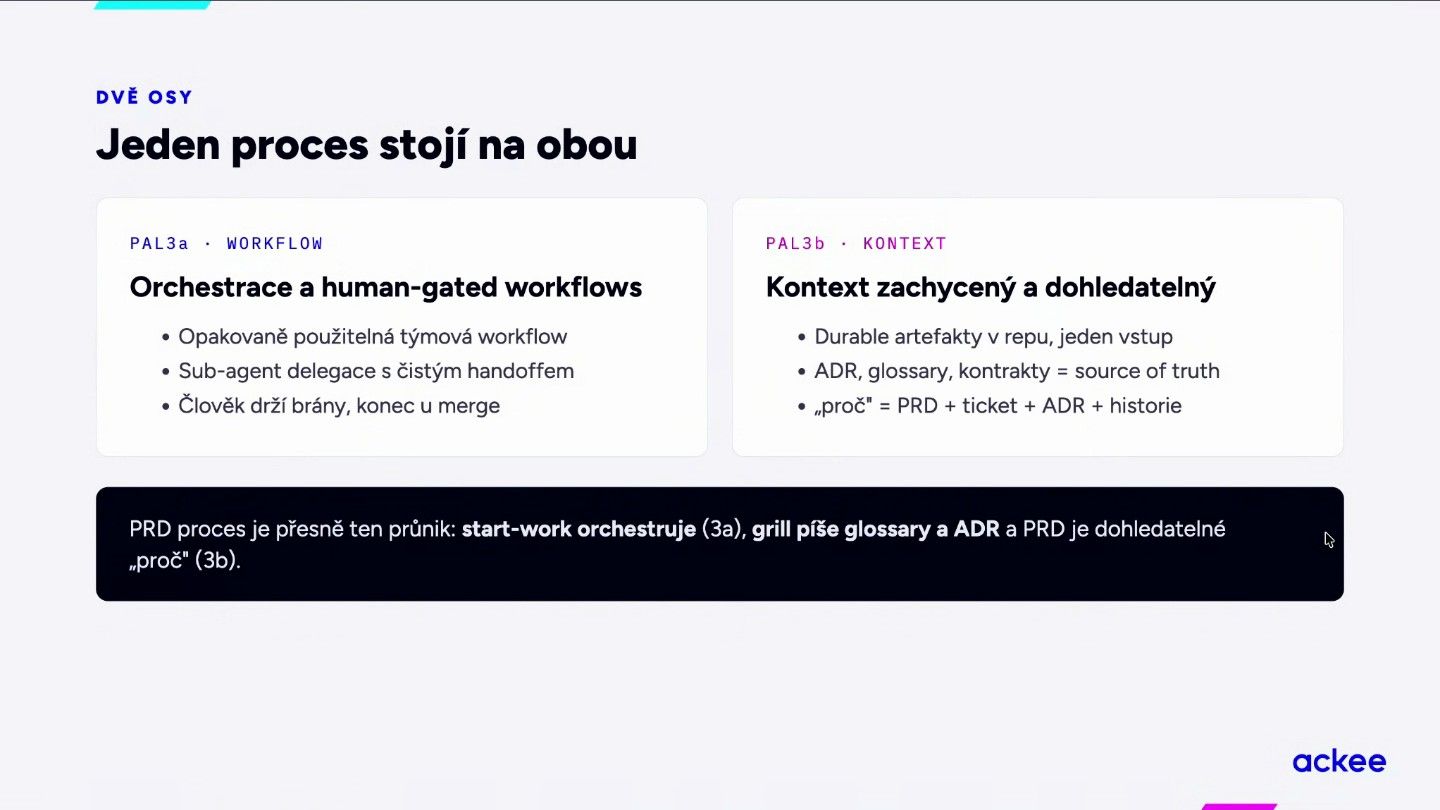
Ackee měří pokrok v adopci AI podle vlastních úrovní (AI adoption levels, zkráceně PAL). PRD proces pokrývá dvě z nich najednou:
- PAL3a – workflow. Opakovaně použitelná týmová workflows s human gates, delegace na subagenty s čistým předáváním výsledků, člověk drží brány od začátku do merge.
- PAL3b – kontext. Trvalé artefakty v repu s jedním vstupním bodem: ADR, glossary a kontrakty jako zdroj pravdy. „Proč“ se dá dohledat z PRD, tiketu, ADR a historie commitů.
🛤️ Od tiketu k merge requestu: start-work a subagenti
Celý proces má šest kroků. Na vstupu je tiket v Redmine (change request, bug, incident nebo feature). Ten zpracuje start-work: provede intake a klasifikaci a hlídá human gates. Následuje cesta podle typu tasku, případně s tvorbou PRD, pak plán rozdělený na fáze a platformy, do-work (implementace, ověření, finální review, commit) a nakonec push a merge request – ten jen na výslovný pokyn člověka.

Start-work se snaží co nejvíc práce delegovat na samostatné subagenty. Každý vrací artefakt, který přežije compact i vyčištění kontextu a šetří tokeny:
| Subagent | Co dělá |
|---|---|
| ticket-intake | stáhne tiket, parent tiket a zdroje, připraví klasifikační shrnutí |
| design-intake | přečte framy z Figmy a vrátí shrnutí designu |
| grill-with-docs · to-prd | sladění a sepsání PRD (cesta A) |
| plan-review · prd-review | nezávislá kritika v čistém kontextu před schválením |
| do-work | celá implementace: implement, verify, review, commit |
Orchestrátor je „tenký router“. Drží jen rozhodnutí a shrnutí, těžká práce běží v odděleném kontextu subagentů a hlavní session zůstává čistá. Ticket intake má navíc dva režimy. Light stáhne jen Redmine, parent tikety a přílohy, což stačí na odhad velikosti tasku. Full jde i do bankovních zdrojů a Confluence.
🔀 Klasifikace tasků: cesty A, B a C
Klasifikátor podle načtených zdrojů rozdělí tasky do tří cest:
- Cesta A – PRD neexistuje. Nová větší feature pro obě platformy, změna přes víc vrstev, nový flow, nová doména nebo nový či změněný backendový kontrakt. Následuje grilování a vznik PRD.
- Cesta B – PRD existuje. PRD už je přiložené u tiketu nebo jeho parenta, typicky proto, že ho vytvořila druhá platforma. Agent nestahuje další detaily z Confluence (byla by to drahá a kontraproduktivní příprava) a jde rovnou na plán.
- Cesta C – malá změna. Bug, incident nebo prokazatelně malá úprava v jednom modulu, bez nového flow a kontraktu. Natália ji používá typicky tehdy, když ví, kde bug je, a jen ho nechce psát ručně.

Výchozí volba nikdy není cesta C. Tiket, který musí definovat chování, patří do cesty A, i když je v trackeru vedený jako bug. Při pochybnostech se agent zeptá.

🔥 Cesta A: grilování proti doméně
Když PRD neexistuje, nastupují tři skilly: grill-with-docs, to-prd a prd-to-ticket.
Grill-with-docs vychází ze skillu grill-with-docs Matta Pococka. Agent vede s člověkem důkladný rozhovor proti všem zdrojům:
- jde do hloubky, jednu otázku po druhé, a ke každé nabízí doporučenou odpověď,
- napadá slabá místa a over-engineering,
- připraví otevřené otázky pro backend a produkt, které si člověk může rovnou odnést na workshop s klientem,
- průběžně zapisuje pojmy do glossary a rozhodnutí do ADR.
Platí jedno důležité pravidlo: slovník se bere jen z řeči lidí a ze specifikací, nikdy z názvů v kódu. Kód slouží k ověření, ne jako zdroj slovníku.
To-prd z rozhovoru sepíše malé PRD a pak se zastaví a čeká na schválení člověkem. Prd-to-ticket je záměrně jednoduchý skill: najde parent tiket a PRD do něj vloží. Výsledkem je schválené PRD na parent tiketu a glossary s ADR ve sdílené dokumentaci, ke které má přístup i iOS.
Jak se obejít bez monorepa
Celý flow by byl jednodušší s monorepem, které projekt zatím nemá. Tým se proto rozhodl, že zdroj pravdy (glossary a ADR) bude žít v repozitáři Android aplikace. iOS k němu má přístup přes sdílený Kotlin Multiplatform modul, který je do projektu nalinkovaný.
Z Androidu tak všechno funguje přímo. Na iOS je potřeba berlička: skill /contribute-shared-docs na konci session (až po finálním review) vyzve člověka, udělá rychlý průchod git diff a nové pojmy a ADR pošle jako merge request do Android repa. Natália k tomu doporučuje, aby merge requesty na glossary a ADR schvaloval vývojář z druhé platformy. Lidé tak navzájem kontrolují, co agent vyprodukoval a jestli názvy odpovídají realitě.
📝 Jak vypadá PRD: šablona, která drží scope
PRD žije v parent tiketu (change requestu), ne v repozitáři. Má být nezávislé na platformě, takže v něm nejsou názvy tříd ani umístění v kódu. Tým ho popisuje jako něco mezi technickou a byznysovou analýzou. Plní tři role:
- Kontrakt pro člověka: co stavíme, proč a jak poznáme hotovo. Schvaluje se před plánem.
- Vstup pro plánovač: plánovací skill rozdělí PRD na fáze podle stories a kritérií.
- Vodítko pro druhou platformu: sdílený kontrakt pro iOS i Android, skutečné PRD navíc nese implementační referenci.

Šablona má sekce TL;DR, Problem, Solution (diagram má přednost před prózou), User Stories a Requirements, Success Criteria (měřitelná), Edge cases a chování při chybách, Decisions (zaznamenaná, ne nově dělaná rozhodnutí), Open Questions a Out of Scope. Hlavička je vždy stejná: zdroje, ze kterých se vycházelo, odkazy na glossary, ADR a vzniklé handoffy, a rozsah (parent a child tikety – jeden kontrakt, dvě platformy).
Obsah se liší podle tasku. Strukturovaná adresa podle ISO 20022 místo volného textu u plateb SWIFT a SEPA byla jasná věc, takže stačilo zhruba stořádkové PRD. Indikace a vyhledávání ESG zasahovaly víc do backendu, a PRD proto obsahovalo i datový kontrakt. U deduplikace podpisové obrazovky bylo složité hlavně chování, takže PRD neslo pseudokód a návod k logice. Nebyl to Swift ani Kotlin, ale pořádná specifikace toho, jak se má logika chovat.
Petrovi zprvu přišla zbytečná, nakonec se ukázala jako jedna z nejužitečnějších. Claude totiž rád rozšiřuje zadání („tohle by ještě šlo upravit, tamto zarovnat“). Výslovný seznam toho, co se v tasku neřeší, ho drží v mezích.
PRD se aktualizuje i během implementace a po ní, když přijde změna nebo se narazí na něco, s čím analýza nepočítala. Jen tak zůstane platným zdrojem i do budoucna.
🚦 Human gates: kde proces zastaví na člověka
Protože je flow nový a tým ho ladí, je v něm zatím hodně míst, kde agent čeká na člověka:
- Potvrzení cesty u A nebo B, než se pustí do drahé práce.
- Grilování – rozhovor s člověkem se nedeleguje.
- Schválení PRD – tvrdá pauza, před ní proběhne prd-review.
- Schválení plánu – po plan-review.
- Verify a finální review – deterministické brány „funguje to?“, plus kontrola v IDE.
- Push, merge request a zápis do Redmine – jen na pokyn, zápis do Redmine je povolený jen na dvou místech.
- Contribute-shared-docs – na konci iOS session, spouští ho jen člověk.
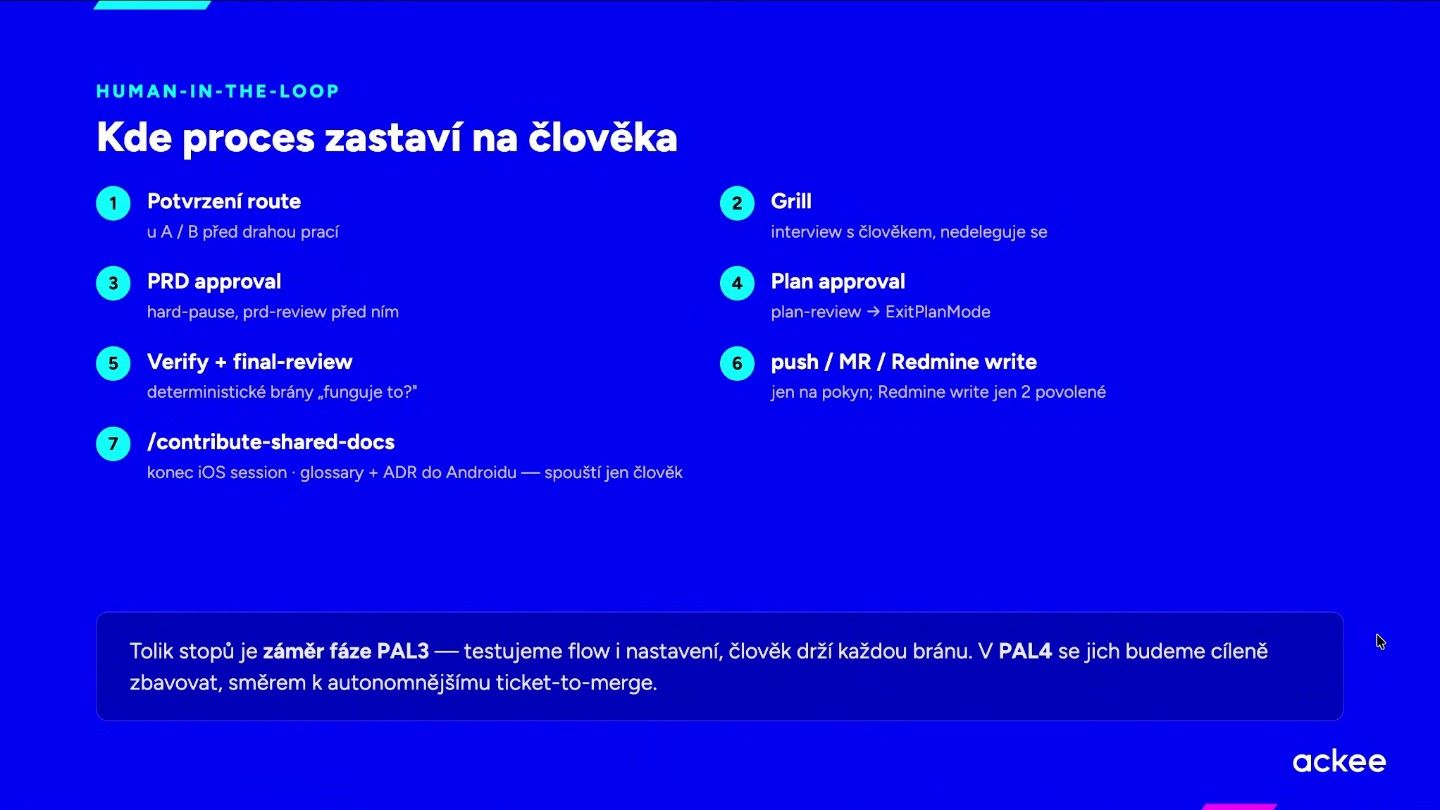
Tolik zastávek je záměr: tým flow i nastavení teprve ladí a člověk drží každou bránu. Jakmile se proces osvědčí, chce se jich cíleně zbavovat, směrem k autonomnějšímu procesu od tiketu po merge. Jedna brána ale nejspíš zůstane: zápis do Redmine. Tikety tam vidí přímo klient, takže tým kontroluje, aby agent nenapsal nic, co se s klientem sdílet nemá.
🗂️ Dohledatelný kontext: glossary, ADR a kontrakty
Druhou osou procesu je kontext, který se dá dohledat:
CONTEXT-INDEX.md– jeden vstupní bod, importovaný doCLAUDE.md.- ADR log – sdílená složka s architektonickými rozhodnutími. Záznamy se needitují, jen se nahrazují novými.
- Glossary a kontextová mapa – jednotný jazyk a hranice kontextů (pojmy z domain-driven designu), sdílené s iOS.
- Kontrakty jako zdroj pravdy – GraphQL submodul, schéma lokální databáze, napojení na Figmu a ověřování proti skutečně nasazenému backendu.
- Konstelace „proč“ – PRD, tiket, ADR a historie commitů dohromady.

Grilování a to-prd tuhle vrstvu průběžně plní: glossary a ADR vznikají během grilování, ne dodatečně.
💬 Co se změnilo v praxi
Největší rozdíl Natália vidí v práci s informacemi. Dřív se stávalo, že po týdnu přišel Petr s okrajovým případem, na který nepomyslela. Teď se takové věci vyřeší během grilování. Přínos je vidět i dlouhodobě: PRD, které někdo vytvořil před dvěma týdny, je pořád použitelné.
„Pre mňa osobne bola tá zmena najviac viditeľná v tom, že to bol jeden dokument, ktorý som musela čítať, a nemusela som hľadať zdroje naprieč všetkým za VPN-kou aj pred ňou.“
Natália i Petr proto doporučují nasadit PRD flow i na další projekty. Celý postup stojí na obyčejných skillech, které se jen poskládají dohromady, a výstupy jsou díky jednotnému workflow v Claude Code konzistentní napříč týmem.
Často kladené otázky
🎯 Co si odnést
PRD flow není byrokracie navíc, ale průsečík dvou věcí: workflow, které agenta vede krok za krokem s branami pro člověka, a kontextu, který se zachytí a dá se dohledat. Start-work rozhodne, jestli se griluje, čte hotové PRD, nebo jde rovnou na opravu. PRD pak slouží člověku jako kontrakt, plánovači jako vstup a druhé platformě jako vodítko.
Pro projekty s více platformami je to zásadní: jedna platforma udělá analýzu, druhá si vezme hotový kontrakt. Subagenti drží kontext čistý, orchestrátor jen rozhoduje a deleguje. A znalost, která by jinak zůstala v hlavě jednoho vývojáře, zůstane v PRD.
Pokud vás zajímá, jak tentýž tým sdílí s Androidem kód, ne jen zadání, přečtěte si článek o Kotlin Multiplatform v bankovní aplikaci.
Minisérie z AI pivka: Kvalita outputu AI agenta: pět vrstev a workflows · Autonomní oprava bugů: od tiketu k merge requestu

Podobné postřehy z Ackee najdete v newsletteru – přihlaste se a příští takový obsah vám přijde přímo do schránky.


