
Většina času při opravě bugu nepadne na samotnou opravu, ale na rutinu kolem ní. Hynek Braun ukázal pipeline, ve které AI agent dostane tiket z Redmine a vrátí buď merge request s opravou, nebo doložené vysvětlení, proč chyba není v aplikaci. Článek vychází z jeho vystoupení na AI pivku v září 2026, interním meetupu, kde si vývojáři Ackee sdílejí, jak s AI agenty skutečně pracují.
📋 TL;DR
- Ruční oprava bugu měla deset kroků: otevřít tiket, zabrat ho, vyzkoušet repro kroky, stáhnout logy, dát je do repa, předat Claudovi, spustit ho, zkontrolovat výstup, zvalidovat opravu a založit merge request.
- U backend-heavy aplikace se často až v sedmém nebo osmém kroku ukáže, že chyba vůbec není na mobilu. Spotřebuje to spoustu času i kontextu.
- Cíl: dám agentovi tiket a dostanu jedno ze dvou – merge request s testem podle repro kroků, nebo komentář v Redmine s důkazy, že chyba je jinde.
- Pipeline je složená z hotových kostiček ve sdíleném marketplace: tool gate, fetch context, triáž, implementace a merge request.
- Nejdůležitější je fetch context: agent musí dostat všechny podklady, jinak nevyřeší ani snadný bug. Kroky musí jasně říct, kdy se zastavit a co vrátit člověku.
- Člověku zbývají tři kroky z deseti: otevřít tiket, vyzkoušet repro kroky, zvalidovat výsledek.
- Blokery: dva iOS simulátory na stroj, chybějící reprodukce a ověření opravy a neschopnost pracovat s videem.
- Pro autonomní práci je klíčové pořádné logování do systémového logu, ne
print.
🐛 Deset kroků jednoho bugu
Ruční oprava bugů byla dlouhá rutina. Když vývojář dostal klientský bug, otevřel tiket, zabral ho, vyzkoušel repro kroky, stáhl logy a dal je do repozitáře, aby se v nich Claude mohl hrabat. Pak Claudovi předal repro kroky a logy, nechal ho pracovat, zkontroloval výstup, ověřil opravu a založil merge request.

Na mobilní aplikaci streamovací platformy, na které Hynek pracuje, to má ještě jeden háček. Aplikace je hodně závislá na backendu a v logách je zachycená zhruba půlka jejího chování. Často se tak ukáže, že chyba není na straně aplikace vůbec: API poslalo špatný text. Jenže na to se přijde až v sedmém nebo osmém kroku, po spoustě spotřebovaného času a kontextu.
🚀 Ideální flow: tiket dovnitř, výsledek ven
Hynek chtěl, aby to fungovalo takhle: agent dostane tiket a vrátí jedno ze dvou.
- Není to náš bug. Odpověď v Redmine s vysvětlením a důkazy, aby se tiket mohl rovnou přehodit na backend.
- Merge request. Popis toho, co bylo špatně, a testovací případ odpovídající repro krokům.

K takovému stavu se tým už hodně přiblížil. Většina kostiček přitom existovala: stačilo je slepit a navázat na sebe.
🧱 Pipeline z hotových kostiček
Pipeline se spouští jedním příkazem s ID tiketu z Redmine a má pět kroků:
- Fetch context – stáhne tiket, komentáře, navázaný záznam v klientském trackeru, logy a screenshoty.
- Triáž – sestaví hypotézu o příčině a podloží ji důkazy, nebo konstatuje, že příčina potvrzená není.
- Rozhodnutí: patří oprava do aplikace? Pokud ne (chyba je na backendu, aplikace funguje podle návrhu, příčina se nepotvrdila), agent zapíše zjištění do komentáře v Redmine a tiket přepne do stavu Feedback.
- Implementace – oprava a validace, nejvýš tři pokusy.
- Merge request – s přiloženou triáží, tiket se přepne do stavu To be merged.
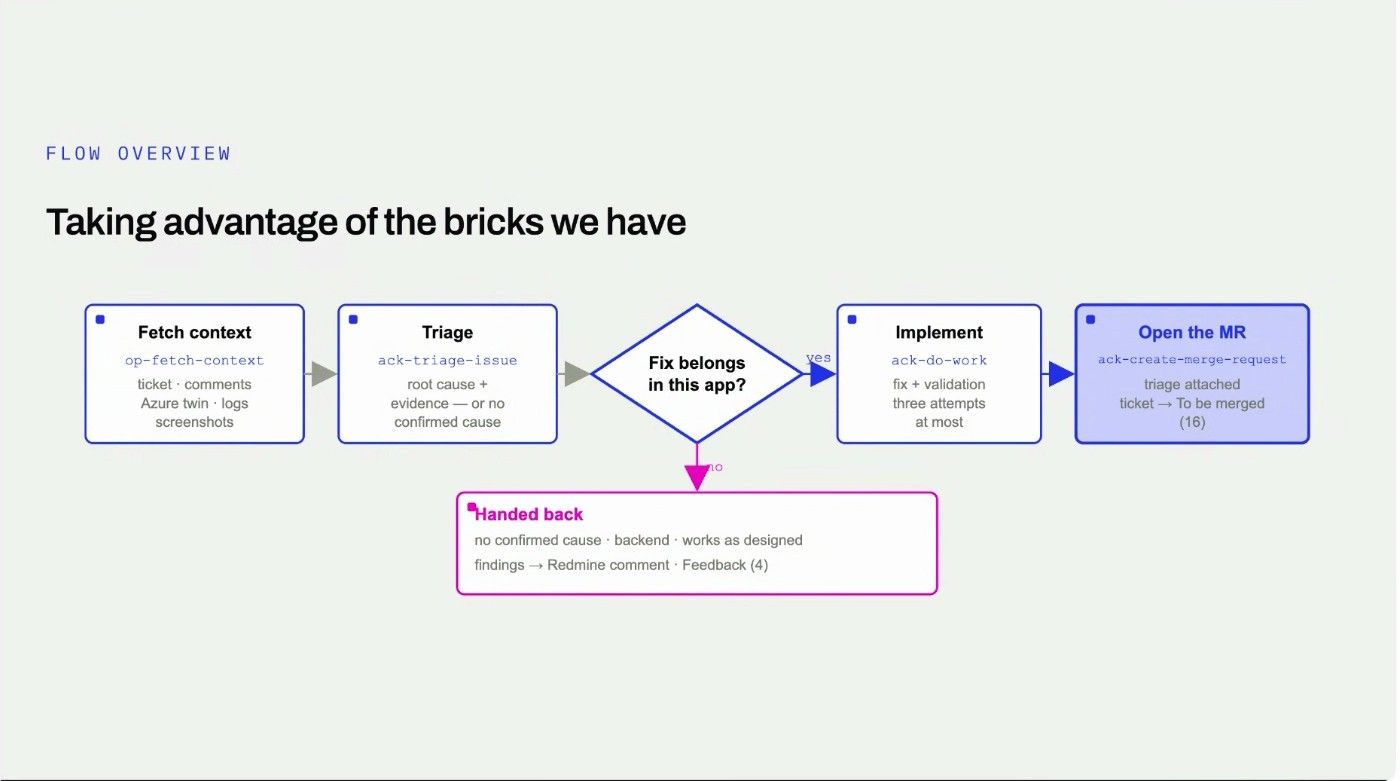
Triáž je motor celé pipeline a zatím jediná část, která skutečně rozhoduje o výsledku. Implementaci obstarává stejný skill, jaký tým používá u features. Kromě fetch contextu jsou všechny kostičky ve sdíleném marketplace Ackee.
Fetch context: agent musí znát všechno
Fetch context je nejdůležitější krok. Když má agent běžet autonomně, musí mít k dispozici všechno. Stávalo se, že agent nevyřešil i snadný tiket jen proto, že neměl nalinkovaný správný soubor.
Skill proto obsahuje základní instrukce a reference pro jednotlivé typy flow. U feature tiketů ví, že má načíst architektonickou, API a produktovou specifikaci. U klientských bugů vždy stahuje log, bez kterého je slepý agent i vývojář. Nikdo ho přitom nechce pustit volně do klientského trackeru, protože by se tam mohl hrabat donekonečna a výsledek by nebyl předvídatelný. Reference dělají krok deterministický a škálovatelný: když se změní typ zadání, stačí přidat novou referenci. Jen se nesmí rozbujet. Čtyřicet referencí by už ideální nebylo.
🛑 Lepidlo: kdy se pipeline zastaví
Na schématu vypadá pipeline jednoduše, v praxi má agent velké nutkání se zasekávat. Tým proto musel u každého kroku vyřešit, kdy se zastavit a co vrátit člověku.
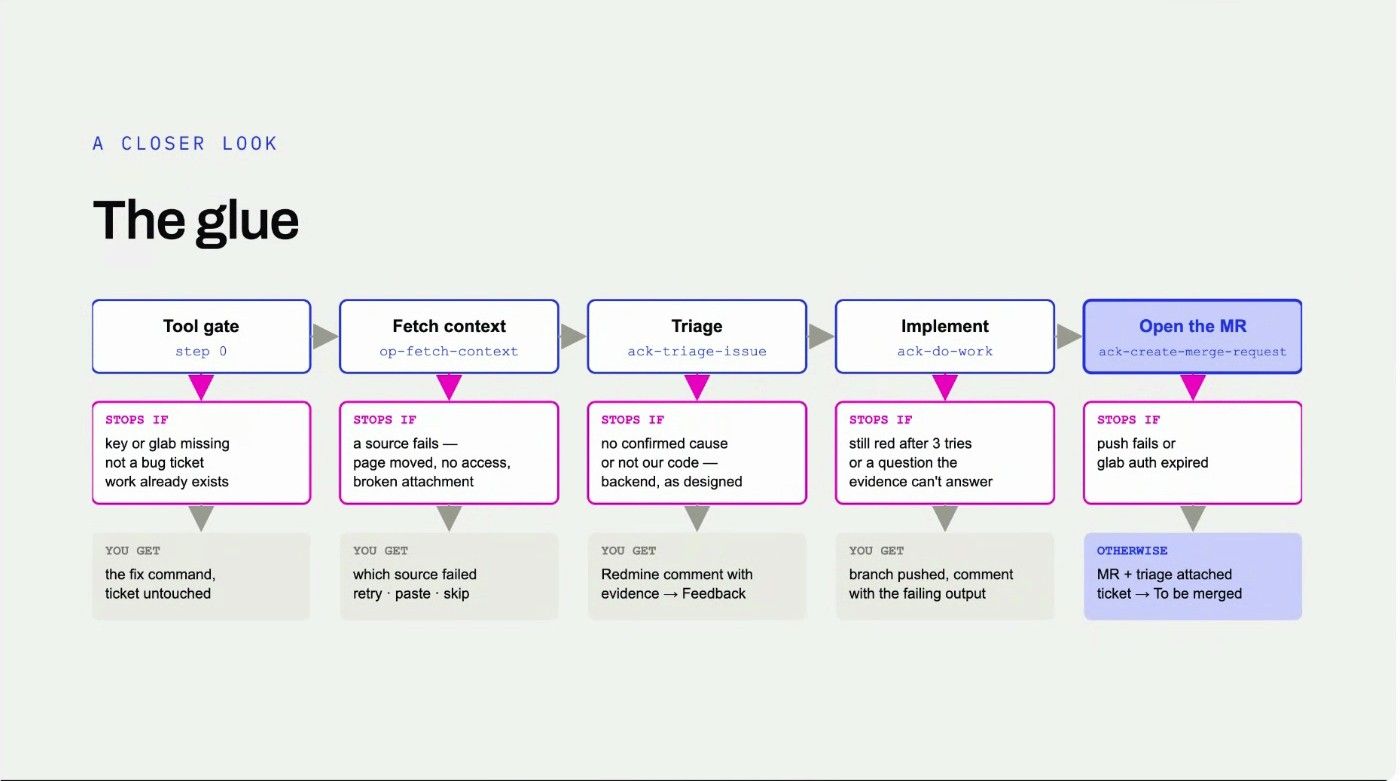
| Krok | Zastaví se, když… | Člověk dostane |
|---|---|---|
| Tool gate | chybí API klíč nebo GitLab CLI, tiket není bug, práce už existuje | příkaz na opravu, tiket zůstane nedotčený |
| Fetch context | zdroj selže: stránka se přesunula, chybí přístup, příloha je rozbitá | který zdroj selhal a volbu zkusit znovu, vložit ručně, nebo přeskočit |
| Triáž | příčina se nepotvrdila nebo není v kódu aplikace | komentář v Redmine s důkazy, stav Feedback |
| Implementace | ani po třech pokusech neprojdou kontroly nebo vznikne otázka, na kterou důkazy neodpoví | pushnutou větev a komentář s výstupem, který selhal |
| Merge request | push selže nebo vyprší přihlášení do GitLabu | informaci, co selhalo; když vše projde, merge request s triáží a tiket ve stavu To be merged |
Úvodní tool gate je preflight kontrola: má agent API klíč do Redmine a všechno ostatní, co flow potřebuje? Bez ní by agent udělal dva tři kroky a pak se zasekl. Když selže některý zdroj, agent se nemá zaseknout, ale dát vědět: napíše do Redmine a ideálně přehodí stav tiketu, aby si ho tým všiml.
Zádrhele bývají nečekané. Agent například narazil v přiloženém logu na přihlašovací údaje testovacího účtu, vyhodnotil je jako důvod se zastavit a odmítl pokračovat. Tým mu musel výslovně popsat, se kterými daty smí pracovat. Triáž zase z hypotézy generovala otázky a pokládala je člověku. V autonomním flow proto dostala pokyn, aby si na konzultaci spustila dalšího agenta a nevracela otázky lidem.
„Agent je schopný se zaseknout na jakékoli blbosti. A když mu na začátku řeknete, že to má být autonomní flow, zasekne se v každé fázi.“
Dnes podle Hynka flow doběhne prakticky vždy. Kroků není mnoho a podařilo se je „uškrtit“, aby nevypadávaly. Lidé v týmu si ale vyžádali možnost zastavit pipeline po triáži a hypotézu si ověřit, než agent pokračuje. Pipeline proto má přepínač do manuálního režimu. Ve výchozím nastavení jede automaticky.
🔬 Co pipeline zvládla na reálných tiketech
Na reálných tiketech se ukázalo, co pipeline zvládne a kde má limity:
- Špatné pořadí položek v nastavení. Nastavení se většinou načítá z backendu, ale tahle obrazovka byla v aplikaci natvrdo. Agent si poradil sám, včetně logů z Androidu, které přicházejí zazipované a dřív je bylo nutné ručně rozbalovat.
- HTML entity v textu. Chyba z produkce, kde logy nejsou. Backend posílal HTML prvky, se kterými aplikace nepočítala. Agent problém našel sám, i když šlo o iOS tiket a pipeline spouštěl Android vývojář.
- Chybějící analytický event. Ukázka předčasného konce: agent zjistil, že v odpovědi z backendu chybí tracking data, takže aplikace neměla co logovat. Tiket vrátil do Redmine s vysvětlením. Ideálně by šel rovnou do klientského trackeru, to ale tým zatím riskovat nechce.
- Nepodporovaný chybový kód. Agent začal opravovat nesmysly, protože mu chyběla reference na seznam chybových kódů. Stačil by jeden odkaz do dokumentace.

Poslední příklad je nejcennější lekce: nenadávat, že to agent neudělal správně, ale hledat, proč to neudělal. Na složitější chyby zatím pipeline tým nepouští, tam výsledky nestojí za to.
Z deseti ručních kroků teď člověku zbývají tři: otevřít tiket, vyzkoušet repro kroky a zvalidovat opravu.

🚧 Co ještě chybí: reprodukce, verifikace a video
Cílová podoba pipeline má dva nové kroky. Reprodukce projde repro kroky z tiketu na skutečném buildu. Ověření opravy po implementaci zopakuje stejné kroky a zkontroluje, že symptom zmizel. Pokud ne, oprava se opakuje, nejvýš třikrát. Agent by si při reprodukci zapsal stav aplikace, aby ho po opravě mohl porovnat.

Do fetch contextu má přibýt práce s videem. Testeři často k tiketu přikládají video a pipeline ho zatím zahazuje. Hynek zkoušel rozsekat video na snímky pomocí FFmpegu a provázat je s časy v logu, takže agent může vytáhnout screenshot přesně ve chvíli, kdy ho potřebuje.
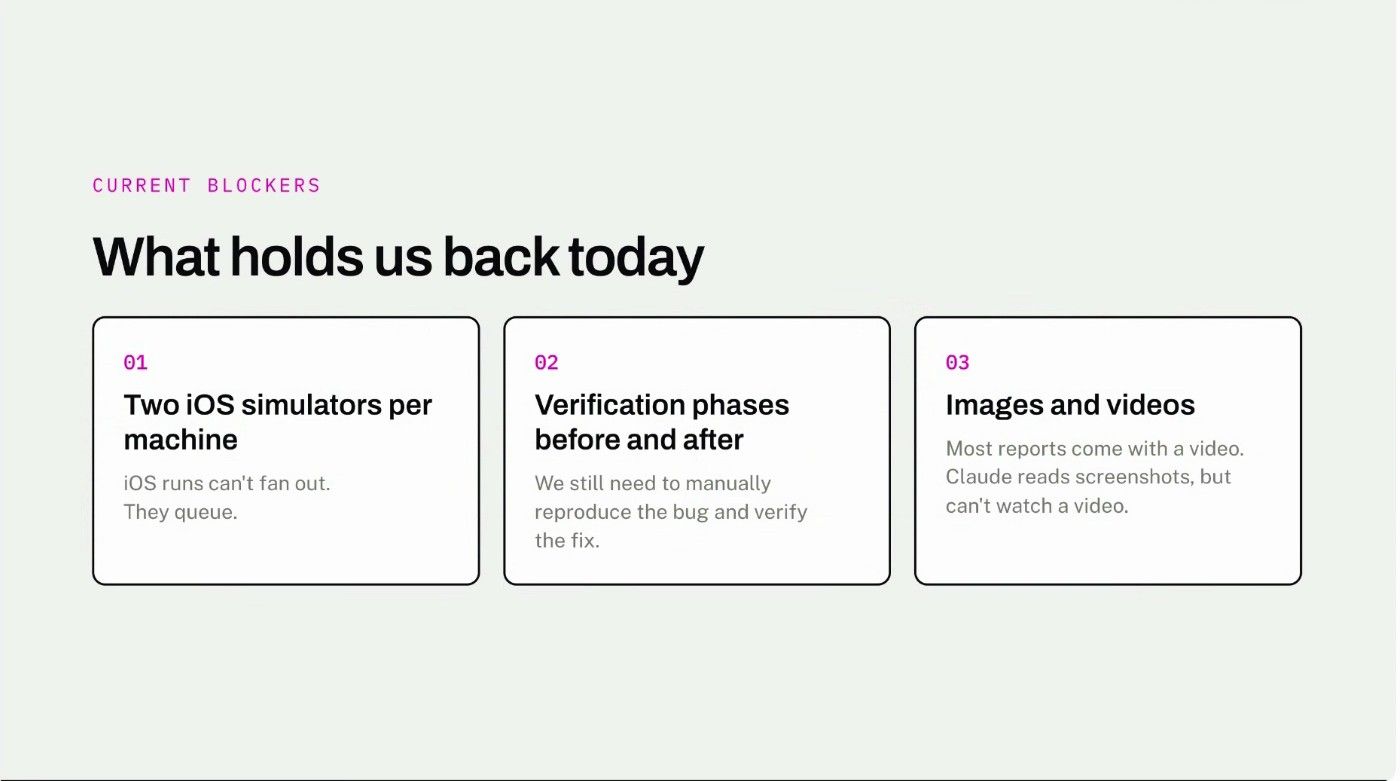
Současné blokery jsou tři:
- Dva iOS simulátory na stroj. Běhy na iOS nejde škálovat, řadí se do fronty. S emulátory Androidu je to technicky snazší, ale jsou náročnější na zdroje. Kdyby každý vývojář ráno pustil pipeline na tři bugy s validací, infrastruktura by to neunesla.
- Verifikace před a po. Agent zatím neumí konzistentně proklikat aplikaci. Cesta vede přes accessibility identifikátory, ale musí to někde spolehlivě běžet.
- Obrázky a videa. Claude čte screenshoty, ale video sledovat neumí.
Cílem je, aby pipeline běžela na interní agentní infrastruktuře Ackee, bez vývojářského počítače. Dál tým zvažuje:
- samo se zlepšující review rules – komentáře z merge requestů se mění v pravidla, takže je potřeba je psát tak, aby se z nich agent mohl učit, ne jen „tohle se mi nelíbí“,
- malé refaktory přes noc – jeden merge request na každý, připravený do rána,
- pády z Crashlytics rovnou k opravě – pád, úkol v Redmine, oprava, upozornění na Slacku.
📜 Logování: bez něj autonomní práce nejde
Jak moc na logování záleží, ukazuje zkušenost Rostislava Babáčka, který pipeline sám vyzkoušel. První den měl čtyři bugy a pipeline vyřešila tři. U čtvrtého se agent chytil chyby, která v logu nebyla první, ale navazovala na tu původní. Babáček nejdřív myslel, že agent neumí efektivně číst log. Pak zjistil, že chyba, která problém způsobovala, se do logu vůbec nezapisovala. Byla jen vypsaná přes print, takže ji agent neměl odkud vyčíst.
Pro autonomní opravu bugů je pořádné logování do systémového logu jedna z nejdůležitějších věcí. Na streamovacím projektu tým loguje životní cyklus obrazovek, síťovou komunikaci a chyby v jasně daných kategoriích a agentovi předává referenci, co která kategorie znamená. Refaktoring logování podle takového vzoru zvládne Claude na jiném projektu sám a rychle.
S autonomními pipeline se mění i to, jak vypadá den vývojáře. Babáček zmiňuje vzor, kterému se v komunitě říká day shift / night shift: přes den lidé dělají PRD, plány a review, přes noc agenti implementují. Místo neustálého přepínání mezi plánováním, kontrolou implementace a Slackem by si vývojáři vyhradili soustředěné bloky na jeden typ práce. Podle Babáčka může být právě tohle cesta, jak se z agentního vývoje nezbláznit.
Často kladené otázky
print místo zápisu do systémového logu pro něj neexistuje. Pořádné logování v kategoriích je proto podmínkou autonomní opravy bugů.🎯 Co si odnést
Autonomní oprava bugů nestojí na jednom chytrém promptu, ale na poskládání existujících kostiček: preflight kontrola, načtení kontextu, triáž, implementace a merge request. Každý krok přitom musí vědět, kdy se zastavit a co vrátit člověku, jinak se agent zasekne na první maličkosti.
Většina kostiček je obecná a v Ackee je najdete ve sdíleném marketplace pluginů. Projektově specifický je jen fetch context. Stojí za to pustit pipeline na zkušební tikety a sbírat data o tom, co agent opravit zvládne a co ne. S nimi se pak dá i produktovým manažerům říct, které chyby odbaví agent a které nechat lidem.
Jak se AI agenti zapojují do testování mobilních aplikací, popisuje článek o QA s Claude Code a Maestrem. A co by takový agent měl a neměl smět, rozebírá článek o oprávněních v Claude Code. Návrh celého feature flow, ze kterého pipeline přebírá kostičky, najdete v článku o kvalitě outputu AI agenta.
Minisérie z AI pivka: Kvalita outputu AI agenta: pět vrstev a workflows · PRD flow: jedno zadání pro iOS i Android

Podobné postřehy z Ackee najdete v newsletteru – přihlaste se a příští takový obsah vám přijde přímo do schránky.


